
198 lines
6.6 KiB
Markdown
198 lines
6.6 KiB
Markdown
# Kb Retriever Skill — 本地知识库检索
|
||
|
||
> 让 AI Agent 高效回答基于**本地多格式知识库目录**的问题。靠分层索引导航 + 渐进式检索完成,不把整文件塞进 context。
|
||
|
||
[English](./README.md) · [返回集合首页](../../README.zh-CN.md)
|
||
|
||
|
||
|
||
## 这个 Skill 干什么
|
||
|
||
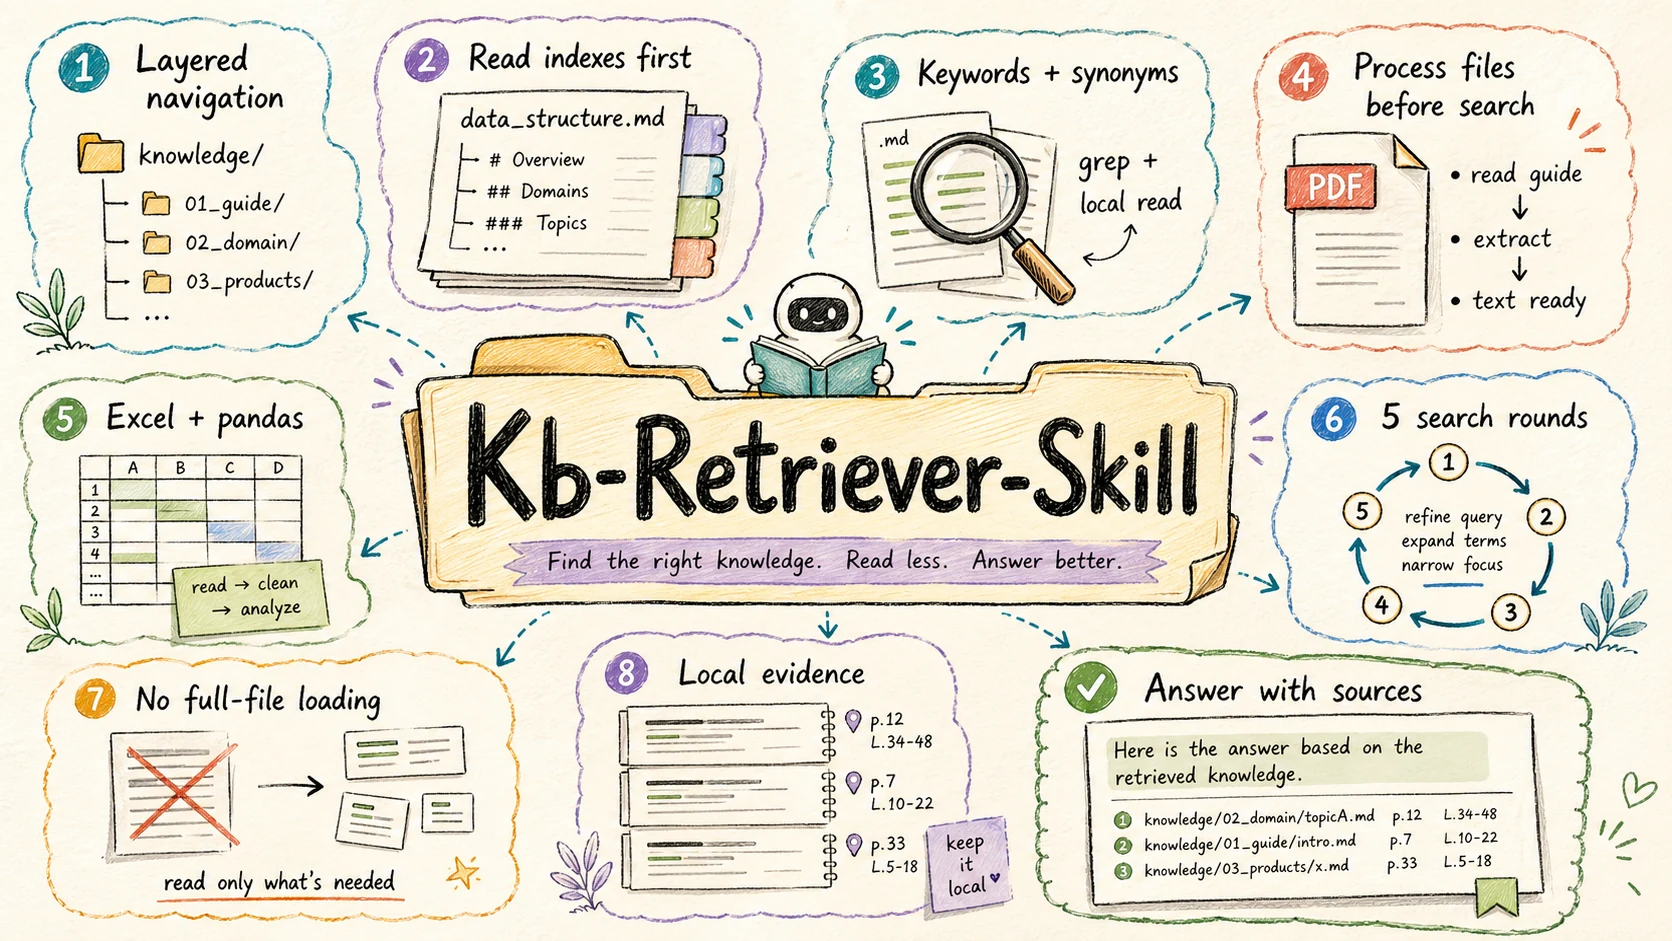
把 Agent 指向一个本地的混合格式知识库目录(Markdown / PDF / Excel 等),用自然语言提问。Skill 会:
|
||
|
||
1. **走分层索引**:沿着每层目录的 `data_structure.md`,判断答案大概率在哪些文件里。
|
||
2. **强制先学习再处理**:碰到 PDF / Excel 时,必须先读对应的 `references/*.md`,按推荐工具去处理,不允许蛮力直接读。
|
||
3. **渐进式检索**:先 `grep` 定位,再用 offset/limit 局部读取,避免整文件加载。
|
||
4. **最多 5 轮迭代**:每轮根据已读到的内容收紧关键词,直到信息足够回答。
|
||
|
||
---
|
||
|
||
## 核心特性
|
||
|
||
- ✅ **多格式支持**:Markdown / 文本、PDF、Excel——按文件类型可扩展。
|
||
- ✅ **分层索引**:每层目录都带一份 `data_structure.md`,组成一棵索引树供 Agent 导航。
|
||
- ✅ **渐进式检索**:grep 优先 + 窗口读取,从不整文件加载,大语料下也能控制住 token。
|
||
- ✅ **强制学习机制**:PDF / Excel 的处理必须先读对应 references。
|
||
- ✅ **有界迭代**:最多 5 轮,带明确终止条件。
|
||
|
||
---
|
||
|
||
## Skill 结构
|
||
|
||
```
|
||
skills/kb-retriever/
|
||
├── SKILL.md 主技能(frontmatter name: kb-retriever)
|
||
├── README.md / README.zh-CN.md 本文档
|
||
├── references/
|
||
│ ├── pdf_reading.md PDF 处理指南(pdftotext / pdfplumber / pypdf)
|
||
│ ├── excel_reading.md pandas 读取 Excel 的方法(nrows / dtype 等)
|
||
│ └── excel_analysis.md Excel 的过滤 / 聚合 / 派生指标方法
|
||
└── scripts/
|
||
└── convert_pdf_to_images.py 当文本抽取失败时把 PDF 转图像的兜底脚本
|
||
```
|
||
|
||
---
|
||
|
||
## 准备你的知识库
|
||
|
||
本 Skill **不自带**知识库——需要你自己提供。两种方式:
|
||
|
||
### 默认路径
|
||
|
||
在调用 Agent 的工作区根目录放一个 `knowledge/`:
|
||
|
||
```
|
||
your-project/
|
||
├── .claude/skills/ 或 .agents/skills/
|
||
│ └── kb-retriever/ ← 本 Skill 目录
|
||
└── knowledge/ ← ← ← 你的知识库
|
||
├── data_structure.md (根级索引,模板见下)
|
||
├── <领域-1>/
|
||
│ ├── data_structure.md
|
||
│ └── ...
|
||
└── <领域-2>/
|
||
└── ...
|
||
```
|
||
|
||
### 自定义路径
|
||
|
||
在你的问题里直接告诉 Agent,例如"用 `./docs` 这个目录回答"或"我的知识库在 `/data/kb`",Skill 会改用你指定的路径。
|
||
|
||
如果默认 `knowledge/` 不存在、用户也没指定路径,Skill 会主动询问而不是瞎猜。
|
||
|
||
### `data_structure.md` 模板
|
||
|
||
每个被索引的目录都建议放一份:
|
||
|
||
```markdown
|
||
# [目录名称]
|
||
|
||
## 用途
|
||
本目录是干什么的、什么场景下应该被检索。
|
||
|
||
## 文件说明
|
||
- file1.pdf —— 内容是什么、时间 / 版本范围
|
||
- file2.xlsx —— 表结构概要、关键列
|
||
- subdir/ —— 子目录用途
|
||
|
||
## 数据范围
|
||
时间范围、版本、数据来源等帮助 Agent 排序优先级的信息。
|
||
```
|
||
|
||
---
|
||
|
||
## 检索是怎么进行的
|
||
|
||
### 1. 分层索引导航
|
||
|
||
每层目录都先读 `data_structure.md`,挑出与问题最相关的子目录或文件,**再递归向下**——不会一次性铺开整棵树。
|
||
|
||
### 2. 先学习,再处理(PDF / Excel)
|
||
|
||
候选集合里出现 PDF 或 Excel 时,**必须**先读对应的 references:
|
||
|
||
```
|
||
✅ 读 references/pdf_reading.md / excel_reading.md / excel_analysis.md
|
||
✅ 理解推荐的工具与参数
|
||
✅ 用该工具完成转换 / 抽取
|
||
⏭️ 现在才能开始检索
|
||
```
|
||
|
||
禁止行为:
|
||
|
||
- ❌ 没读 `pdf_reading.md` 就直接处理 PDF
|
||
- ❌ 没读 `excel_reading.md` / `excel_analysis.md` 就直接处理 Excel
|
||
- ❌ 跳过文件处理直接对原始 PDF / Excel 检索
|
||
|
||
### 3. 渐进式检索
|
||
|
||
- 不读整文件。
|
||
- 先用 `grep` 定位关键词。
|
||
- 只读匹配处的窗口(`limit` ≈ 200–500 行)。
|
||
- 最多 5 轮,每轮收紧关键词。
|
||
|
||
### 4. 按文件类型选工具
|
||
|
||
| 格式 | 工具 | 注意 |
|
||
|---|---|---|
|
||
| Markdown / 文本 | `grep` + 窗口 `read_file` | 必须 offset/limit,不要整文件读。 |
|
||
| PDF | `pdftotext input.pdf output.txt` → 对结果文本 `grep` | **必须输出到文件**,不要走 stdout。超大 PDF 用 `-f / -l` 控制页范围。 |
|
||
| Excel | pandas,先 `nrows` 学结构,再带条件读取 | 先识别关键列(id / time / category),再查询。 |
|
||
|
||
### 5. 迭代循环
|
||
|
||
每轮:
|
||
|
||
1. 生成 / 更新关键词
|
||
2. 选择尚未充分检索的候选文件
|
||
3. 执行 grep / 局部读取
|
||
4. 分析返回的片段
|
||
5. 判断信息是否够回答 → 够则停止;不够进入下一轮。
|
||
|
||
终止条件:信息足够 ✅ 或 达到 5 轮 ⏱️。
|
||
|
||
---
|
||
|
||
## 最佳实践
|
||
|
||
### 推荐
|
||
|
||
1. 永远先从 `data_structure.md` 开始。
|
||
2. 碰到 PDF / Excel 之前**先**读匹配的 `references/*.md`。
|
||
3. 从最相关的文件开始检索,必要时才扩展范围。
|
||
4. 用 `offset` + `limit` 精确控制读取窗口。
|
||
5. PDF 先抽取到文件再 grep,**不要**把二进制塞进 context。
|
||
|
||
### 避免
|
||
|
||
1. ❌ 一次性读取大文件
|
||
2. ❌ 没读 references 就处理 PDF / Excel
|
||
3. ❌ `pdftotext input.pdf -`(stdout)—— 吃 token
|
||
4. ❌ 一次性读取整张 Excel
|
||
5. ❌ 在所有目录里盲目搜索
|
||
|
||
---
|
||
|
||
## 常见问题
|
||
|
||
**Q1:为什么要强制先读 `references/*.md`?**
|
||
保证 Agent 用对的工具配对的参数——否则它要么把整个文件塞进 context,要么挑了个慢 / 坏掉的方法。
|
||
|
||
**Q2:超大 PDF 怎么办?**
|
||
按页范围抽取(`pdftotext -f 1 -l 10`),对结果文本 grep,然后只读匹配页面附近的内容。
|
||
|
||
**Q3:知识库可以放别处吗?**
|
||
可以,问问题时明确告诉 Agent 路径即可("用 `/data/my-kb` 回答")。
|
||
|
||
**Q4:怎么提高检索准确率?**
|
||
使用更具体的关键词、缩小时间 / 文件名范围、用领域术语而非通用词汇。
|
||
|
||
---
|
||
|
||
## 工具依赖
|
||
|
||
本 Skill 假定 Agent 可以使用:
|
||
|
||
- `grep` —— 文本搜索
|
||
- `read_file` —— 带 offset / limit 的窗口读取
|
||
- `pdftotext`(poppler)或 `pdfplumber` —— PDF 文本抽取
|
||
- `pandas` —— Excel 读取 / 分析
|
||
|
||
`scripts/convert_pdf_to_images.py` 是兜底脚本,给那种文本抽取一无所获的扫描版 PDF 用。
|
||
|
||
---
|
||
|
||
## 许可证
|
||
|
||
MIT
|